
 EN
Rollen for det optiske netværk er afgørende for realiseringen af det omfattende AI-netværk. Da AI-belastninger udvides ud over grænserne for et enkelt datacenter, er 400G Ethernet-optiske løsninger til DCI udviklet til en uundværlig kerne-teknologi for moderne AI-datacentrenes netværk. I dagens komplekse AI-datacenterarkitektur er AI-belastninger ikke kun begrænset til ét enkelt datacenter, og for at imødegå udfordringerne ved skaleret AI kræves højhastighedsforbindelser såsom 800G DCI bliver en vigtig måde at opbygge infrastrukturen for kunstig intelligens af næste generation på.
Hvordan AI-belastninger ændrer datacenternets trafikmønstre
AI-infrastrukturen udvikler sig fra at blive skaleret op inden for én enkelt bygning til at blive skaleret ud over en gruppe faciliteter, ofte adskilt af flere kilometer. Når der ikke er mere strøm, plads eller mulighed for at køle en facilitet, bliver det simpelthen ikke længere muligt at skala op AI-belastningen på én enkelt facilitet. Det betyder, at IT-drift skal skala ud ved at sprede belastningen over flere datacentre. Skiftet fra skala-op til skala-ud gendefinerer trafikmønstrene i datacentret. AI-belastninger kræver, at kolossale mængder data flyttes på en præcist synkroniseret måde mellem klusternoderne. De resulterende store øst-vest-datastrømme overgår fuldstændigt de traditionelle datacenternets interconnect-trafikmønstre. Der er en fremtid med uforudsigelig højhastigheds-, højkapacitets-, metropolitansk og campusomfattende datatrafik, som datanetværk i datacentre ikke længere kan håndtere effektivt.
Hvorfor 800G har Blive Kritiske betydning for AI-datacenter-interconnect
AI-træningsclustre fungerer ved hjælp af distribueret parallel behandling, hvilket kræver enorme mængder båndbredde på tværs af mange datacentre for at oprette forbindelse mellem GPU-noder. 400G er ikke tilstrækkeligt til den mængde data, som storskala-træning genererer, i denne skala i datacentrene. Med 800G DCI har du fordoblet kapaciteten pr. bølgelængde og giver operatører mulighed for at oprette forbindelse mellem AI-clustre ved hjælp af én enkelt bølgelængdeforbindelse i stedet for flere parallelle forbindelser. Fodsporet og de driftsmæssige omkostninger er betydeligt lavere. For operatøren i campus- eller metro-type netværk er der behov for den høje kapacitetstæthed, som 800G DCI leverer, for at kunne udføre distribueret træning, og dette sikrer en effektiv brug af fiberoptik.
Den optiske Teknologi Bag 800G DCI: Koherent teknologi, DCO og krav til fiber
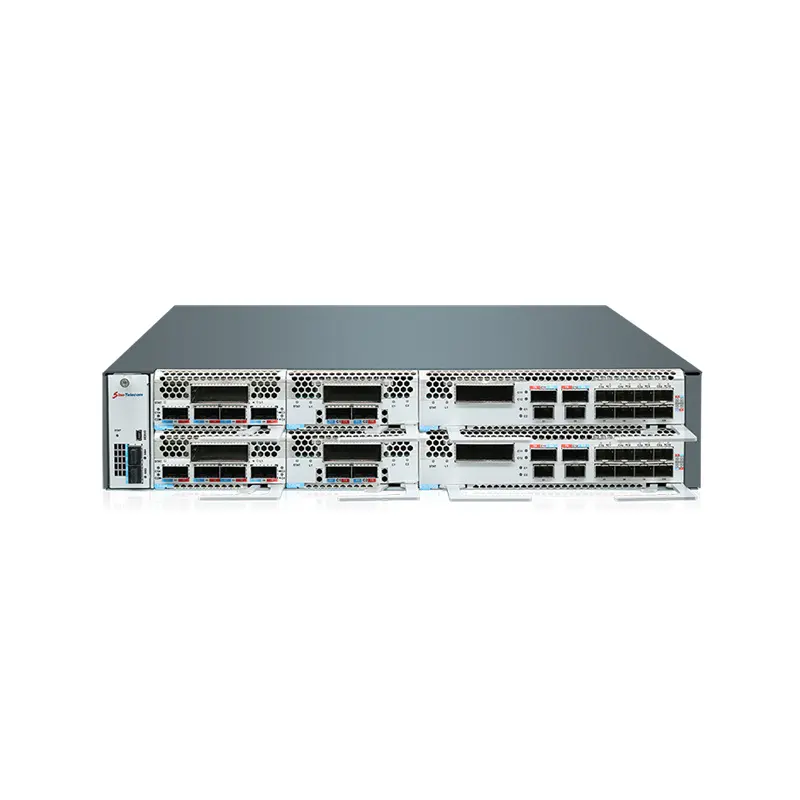
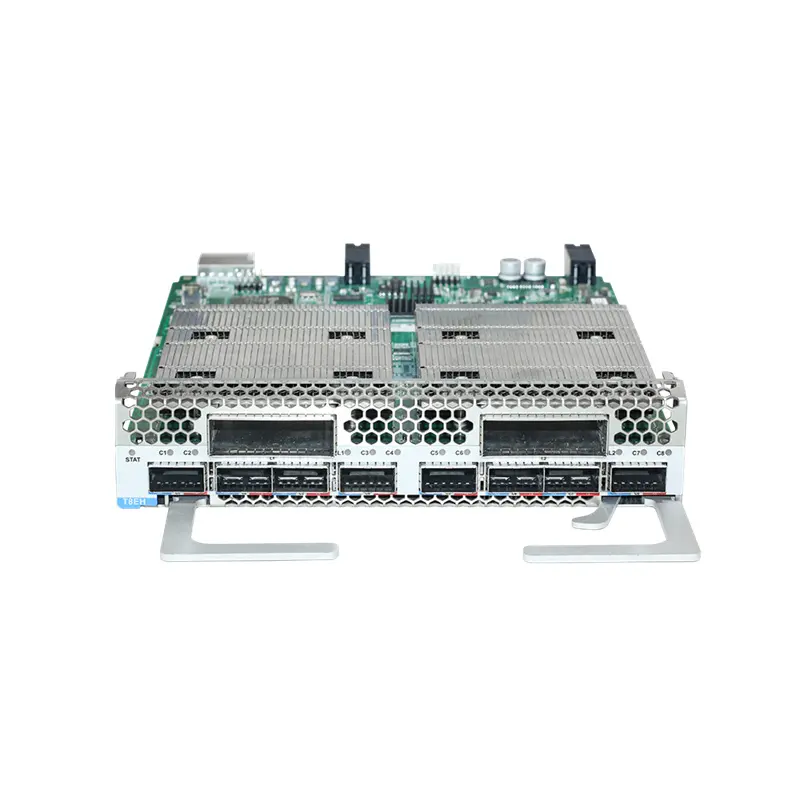
Teknologien bag 800G DCI er koherent optik, fordi den gør det muligt at udnytte lysamplitude og dobbelt polarisering til transmission. Koherent transmission gør det muligt at overføre mere informationstæt data over en enkelt bølgelængde end den traditionelle direkte-detektionsoptik-metode. Ud fra grundlaget af koherent teknologi tilbyder Sino-Telecom DCI-kort med understøttelse af op til 800G pr. kort – og hvert kort understøtter grænsefladerne til optiske moduler via den optiske modulgrænseflade på kortet. Denne understøttelse giver fleksible implementeringsmuligheder.
Designet af DCI-kortet skal også være modulært, så det er muligt at opgradere dets kapacitet efter behov via "hot swapping" af kortet. At have grænsefladeunderstøttelse for flere typer optiske moduler og transmissionafstande på kortet optimerer implementeringsmulighederne og giver os evnen til at skalerer kapaciteten (fra 400G til 800G) nahtløst uden behov for en fuldstændig udskiftning (forklift upgrade).
Udfordringer ved latenstid i AI-klusterforbindelse
AI-træningsopgaver er meget følsomme over for ventetid. Hver mikrosekund-forskel, når forskellige GPU’er i distribueret træning skal samle deres gradienter, kan blive meget kostbar. Derfor vil vores 800G-koherente løsninger levere høj kapacitet med meget lav ventetid.
Implementeringen af 800LR, der er beregnet til ikke-forstærkede afstande på op til ca. 10 km, leverer end-to-end-ventetid under 250 nanosekunder. Sammenlign det med 800ZR-ramming med end-to-end-ventetider, der overstiger 2 mikrosekund. Dette bør muliggøre kortere ventetid med disse fuldt optiske løsninger til AI-klustre af campus-størrelse på nærliggende lokationer. Ved større afstande indføres dog i øjeblikket avancerede arkitekturløsninger, såsom fuldt optiske mesh-netværk med 1 ms kant-til-kern-ventetidscirkler, til AI-træning over større områder. Overordnet set vil ventetiden for 800G-koherente optik stadig være acceptabel i de fleste tilfælde til AI-træning, såfremt afstanden er passende.
Den virkelige verden 800 g Overvejelser ved installation
Implementering af 800G DCI i AI-infrastruktur kræver planlægning inden for flere områder, herunder strøm- og termiske forhold. 800G ZR-moduler kører i intervallet 24–25 W, så strømforbruget skal tages i betragtning. Sørg for at vide, om dine platforme har den rigtige køling til dette – især med hensyn til, hvor mange porte de kan rumme. Tjek, hvilke termiske krav dine switches/routers stiller, når de er fyldt med 800G-porte.
Afstanden skal også indgå i overvejelserne. 800ZR har en rækkevidde på op til 120 km med forstærker og passer til metro-DCI-anvendelsesområder. Vi har lavstrøms 800LR-anvendelsesområder, der reducerer latenstiden for metro-campusnetværk. metro-edge-all-optiske switches kan levere deterministiske latenstider (1 ms, 5 ms og 10 ms) via mesh-topologier og håndtere al AI-trafik for en distribueret cluster.
Forbereder til næste skridt: 1,6T DCI-udviklingen
Og vejen mod 1,6 T ser ud til at være synlig. Som svar herpå arbejder OIF på implementeringsaftaler for 1600ZR og 1600ZR+. Avanceret DSP og en højere baudrate i fremtidens koherente løsninger vil fordoble kapaciteten uden at ofre rækkevidden.
Denne ændring drives af virksomheder som Sino-Telecom. Vi udvikler vores DCI-portefølje ud fra modulære, fremtidssikrede platforme, der understøtter de nuværende 800G-krav og sikrer en simpel opgradering til 1,6 T. Vores optiske platforme omfatter 241 patenter og udnytter et state-of-the-art R&D-centrum til at implementere en række af de nyeste koherente optiske teknologier, herunder den seneste generation, som går ud over 800ZR og ind i 1,6T.
Konklusion
Når AI-udlastningsopgaver flytter sig fra scale-up til scale-out på tværs af distribuerede campus- og metro-klynger, bliver 800G DCI den afgørende byggesten, der leverer dobbelt kapacitet pr. bølgelængde, lav strømforbrug pr. bit og en forsinkelse under 250 ns – kravene for synkron GPU-træning – med en tydelig 1,6T-vejledning, der sikrer, at dine investeringer forbliver aktuelle. Med det modulære Sino Telecom STN6800 D16 OTN-platform og branchens mest omfattende udvalg af 800ZR/800LR-koherente plug-and-play-enheder, et åbent NMS med SNMP/NETCONF-adgang samt en fremtidssikret modulær chassis, klar til enkelte 1,6T-opgraderinger, tilbyder Sino Telecoms optiske lag en afbalanceret kombination af hastighed, rækkevidde, effektivitet og omkostninger – designet til optimal støtte af både nutidens og fremtidens AI-netværkskrav. Som verdens førende globale DCI-leverandør – med over 100.000 enheder installeret verden over – udnytter vi en årti lang ekspertise, en afprøvet og robust supply chain samt en global tilstedeværelse i over 30 lande for at sikre succes i alle faser – fra fiber til den fjerneste node – og for en problemfri og fremtidssikret overgang til AI-datainfrastruktur. Kontakt Sino Telecom Sales Team i dag for et tilbud og et komplet tilbud fra løsningsdesign til implementering, drevet af en årti af lederskab inden for datacenter-interconnectivity.
Indholdsfortegnelse
- Hvordan AI-belastninger ændrer datacenternets trafikmønstre
- Hvorfor 800G har Blive Kritiske betydning for AI-datacenter-interconnect
- Den optiske Teknologi Bag 800G DCI: Koherent teknologi, DCO og krav til fiber
- Udfordringer ved latenstid i AI-klusterforbindelse
- Den virkelige verden 800 g Overvejelser ved installation
- Forbereder til næste skridt: 1,6T DCI-udviklingen
- Konklusion