
 EN
大規模AIネットワークの実現に向けた光ネットワークの役割は極めて重要です。AIワークロードが単一のデータセンターの枠を超えて拡大する中、DCI向け400Gイーサネット光ソリューションは、現代のAIデータセンター・ネットワークにおいて不可欠な基盤技術へと進化しました。今日の複雑化するAIデータセンター・アーキテクチャでは、AIワークロードが単一のデータセンターにとどまらず、スケールしたAIの課題に対応するため、800Gといった高速接続が求められています。 DCI 次世代AIインフラを構築する上で、重要な手段となりつつあります。
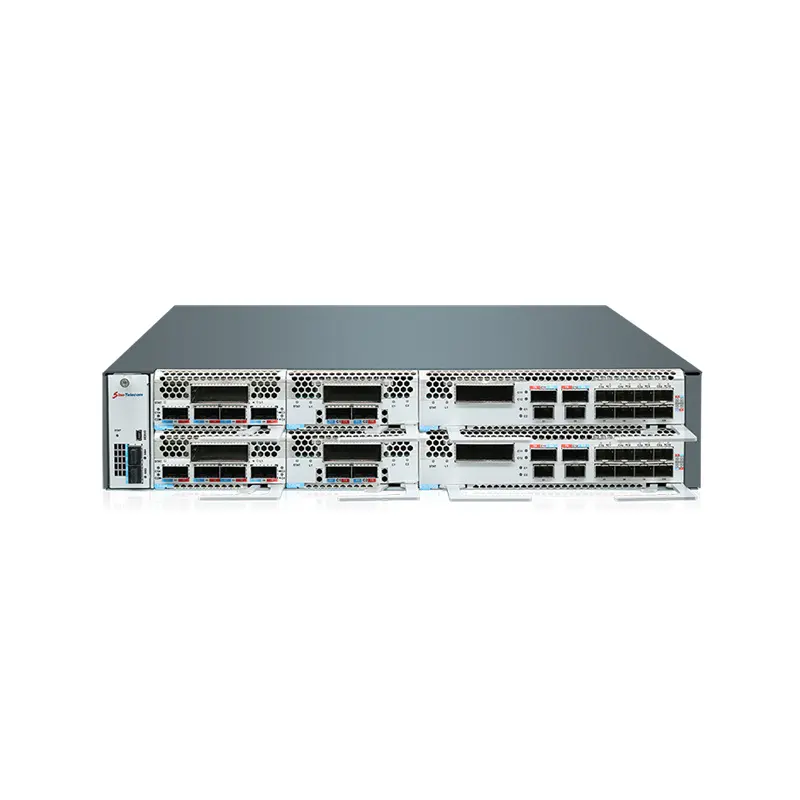
AIワークロードの変化がデータセンター内のトラフィックパターンに与える影響
AIインフラは、単一の建物内での「スケールアップ」から、数マイル離れた複数の施設で構成されるクラスター全体への「スケールアウト」へと進化しています。電力・設置スペース・冷却能力の不足により、ある1つの施設内でAIワークロードをさらに拡張(スケールアップ)することが現実的でなくなっています。このため、IT運用はワークロードを複数のデータセンターに分散させる「スケールアウト」を余儀なくされています。このスケールアップからスケールアウトへの移行は、データセンター内のトラフィックパターンそのものを再定義します。AIワークロードでは、クラスターノード間で大量のデータを極めて厳密な同期のもとで高速にやりとりする必要があります。その結果生じる大規模な東西方向(イースト・ウェスト)トラフィックは、従来のデータセンター間接続(DCI)トラフィックをはるかに上回ります。今後は、予測不能な高帯域・高容量のトラフィックが都市圏やキャンパス規模で発生し、既存のデータセンター向けネットワークではもはや効率的に処理できなくなるでしょう。
800Gが不可欠な理由 なる AIデータセンター間接続(DCI)にとって
AI学習クラスターは分散並列処理を用いて動作します。これには、GPUノードを相互接続するために、多数のデータセンター間で莫大な帯域幅が必要です。大規模な学習によって生み出される膨大なデータ量に対して、400Gではこの規模のデータセンターでは十分な性能を発揮できません。一方、800Gを採用すれば、波長あたりの容量が2倍になり、複数の並列リンクではなく、単一の波長リンクでAIクラスターを相互接続できるようになります。その結果、設置面積および運用コストが大幅に削減されます。キャンパスやメトロタイプのネットワークを運用する事業者にとって、学習タスクの分散処理を実現するには、800G DCIが提供する高い容量密度が不可欠であり、これにより光ファイバーの効率的な活用が維持されます。 DCI 800G DCIの裏側:コヒーレント技術、DCO(ドライバレスコヒーレント光学モジュール)、および光ファイバー要件
光学式フォロプター テクノロジー 800G DCIの裏側:コヒーレント技術、DCO(ドライバレスコヒーレント光学モジュール)、および光ファイバー要件
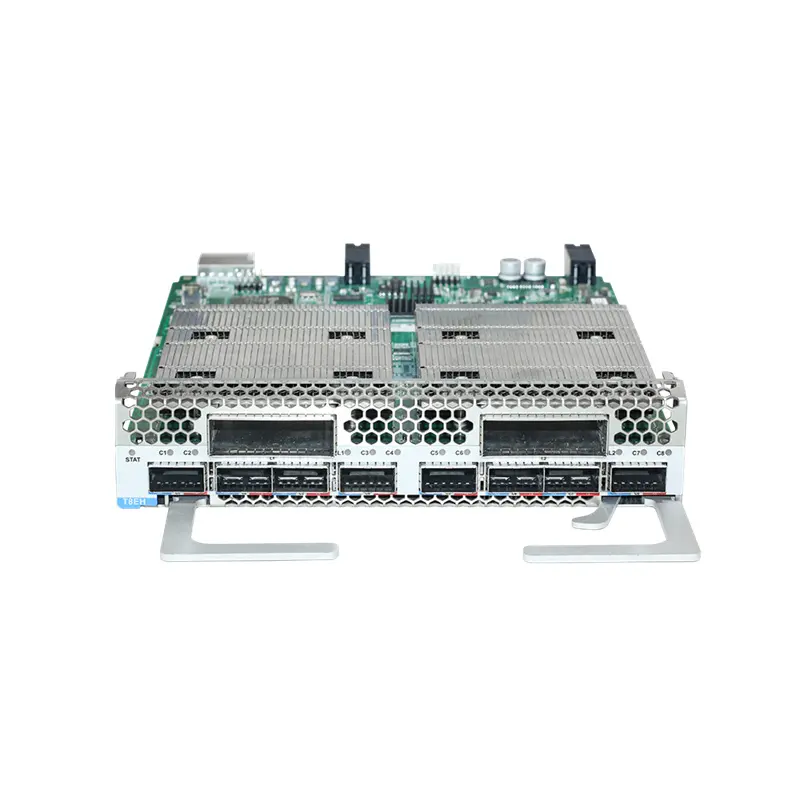
800G DCIを実現する基盤技術はコヒーレント光通信であり、光の振幅および二重偏波を活用した伝送が可能になります。コヒーレント伝送方式は、従来のダイレクト・ディテクション方式と比べ、単一波長あたりにより高密度な情報伝送を実現します。このコヒーレント技術を基盤として、シノテレコムは最大800G/ボードに対応したDCIボードを提供しています – また、各ボードはボード上の光モジュールインタフェースを介して、光モジュールの接続をサポートします。これにより、柔軟な展開が可能になります。
DCIボードの設計はモジュラー式であるべきであり、必要に応じてボードを「ホットスワップ」することで、容量のアップグレードが容易に行えるようになります。さらに、ボード上で複数種類の光モジュールおよび異なる伝送距離に対応するインタフェースを備えることで、展開選択肢が最適化され、400Gから800Gへの容量拡張を、フルリプレース(フォークリフトアップグレード)を伴わずにシームレスに実現できます。
遅延に関する課題 で AIクラスタ間接続
AI学習ワークロードは、遅延に対して非常に敏感です。分散学習において複数のGPUが勾配を統合する際に、わずか1マイクロ秒の遅延差でも、大きなコスト増加につながる可能性があります。そのため、当社の800Gコヒーレントソリューションは、極めて低い遅延で高容量を実現します。
800LR実装は、約10 kmまでの非増幅伝送距離向けに設計されており、エンドツーエンド遅延は250ナノ秒未満を実現します。これに対し、800ZRフレーミングではエンドツーエンド遅延が 2 マイクロ秒を超える場合があります。このため、キャンパス規模のAIクラスタを近距離で接続する際には、こうした全光ソリューションにより、より短い遅延が実現可能です。ただし、より長距離での運用では、エッジからコアまで1ミリ秒の遅延を実現する全光メッシュネットワークなどの高度なアーキテクチャが、広域におけるAI学習向けに現在導入されつつあります。全体として、適切な伝送距離であれば、800Gコヒーレント光学技術の遅延は、AI学習用途においてほとんどのケースで十分に許容範囲内です。
現実世界 800g 導入時の検討事項
AIインフラへの800G DCI導入には、電力および熱管理を含む複数の観点からの計画が必要です。800G ZRモジュールは24~25W程度で動作するため、電力消費は重要な検討事項となります。また、各プラットフォームがこの消費電力に対応できる十分な冷却性能(特にポート密度)を備えているかを確認してください。800Gポートを高密度実装した際のスイッチ/ルーターの熱設計対応状況も、事前に確認しておいてください。
伝送距離も考慮要素です。800G ZRは光増幅器を用いることで最大120kmの伝送が可能で、都市圏DCI用途に適しています。また、都市圏キャンパスネットワーク向けには、低消費電力の800G LRを活用することでレイテンシを低減できます。 さらに、都市圏エッジ向けの全光スイッチを採用すれば、メッシュ構成により確定的なレイテンシ(1ms、5ms、10ms)を実現でき、分散型AIクラスタ全体のトラフィックを一元的に処理できます。
準備中 対応車種 次のステップ:1.6T DCIへの進化
そして、1.6Tへの道筋が見えてきています。これに対応して、OIFは1600ZRおよび1600ZR+の実装合意に向けて作業を進めています。今後のコヒーレントソリューションでは、高度なDSPとより高いボーレートを採用することで、伝送距離を犠牲にすることなく容量を2倍にすることができます。
この変化は、中国電信(Sino-Telecom)などの企業によって牽引されています。当社は、モジュラーで将来にも対応可能なプラットフォームを基盤としてDCI製品ポートフォリオを開発しており、現在の800G要件を満たすとともに、1.6Tへの簡単なアップグレードを保証します。当社の光プラットフォームには241件の特許が活用されており、最先端の研究開発センターを活かして、800ZRを越えて1.6Tへと進化する最新世代を含む多様な先進的コヒーレント光技術を実装しています。
まとめ
AIワークロードが、スケールアップから分散型のキャンパスおよびメトロクラスタへのスケールアウトへと移行する中、800G DCI(データセンター間接続)は不可欠な基盤技術となっています。波長あたりの伝送容量を2倍化し、ビットあたりの消費電力を低減、さらに同期GPUトレーニングに必要な250ナノ秒未満の低遅延を実現します。また、明確な1.6Tへの進化ロードマップにより、お客様の投資を長期にわたり最新の状態に保ちます。シノテレコムのモジュラー型STN6800 D16 OTNプラットフォーム、業界最多クラスの800ZR/800LRコヒーレント・プラグアブルトランシーバ、SNMP/NETCONF対応のオープンNMS、そして将来的な1.6Tアップグレードを簡単に行える将来性を備えたモジュラーチャシスを組み合わせることで、シノテレコムの光ネットワーク層は、速度・伝送距離・消費電力・コストのバランスに優れたソリューションを提供。今日および将来のAIネットワーキング要件を最適に支援します。世界トップクラスのDCIプロバイダーとして、全世界で10万台以上を導入。10年にわたる専門知識、実績と信頼性を証明済みのサプライチェーン、30カ国以上に及ぶグローバルな事業展開を活かし、ファイバーから最も遠いノードに至るまで、あらゆる要素を最適化。AIデータインフラへの円滑かつ将来を見据えた移行を確実にサポートします。本日より、シノテレコム営業チームへお問い合わせください。データセンター間接続分野で10年にわたるリーダーシップを誇る当社が、ソリューションから実装まで、一貫した包括的なサービスをご提供します。