
 EN
광 네트워크의 역할은 대규모 AI 네트워크 구현에 있어 매우 중요하다. AI 워크로드가 단일 데이터 센터의 범위를 넘어 확장됨에 따라, DCI용 400G 이더넷 광 솔루션은 현대 AI 데이터 센터 네트워크의 필수적인 핵심 기술로 진화하였다. 오늘날 복잡한 AI 데이터 센터 아키텍처에서 AI 워크로드는 단일 데이터 센터에 국한되지 않으며, 규모 있는 AI의 도전 과제를 해결하기 위해 800G와 같은 초고속 연결이 요구된다. DCI 차세대 인공지능 인프라를 구축하는 데 중요한 수단이 되고 있다.
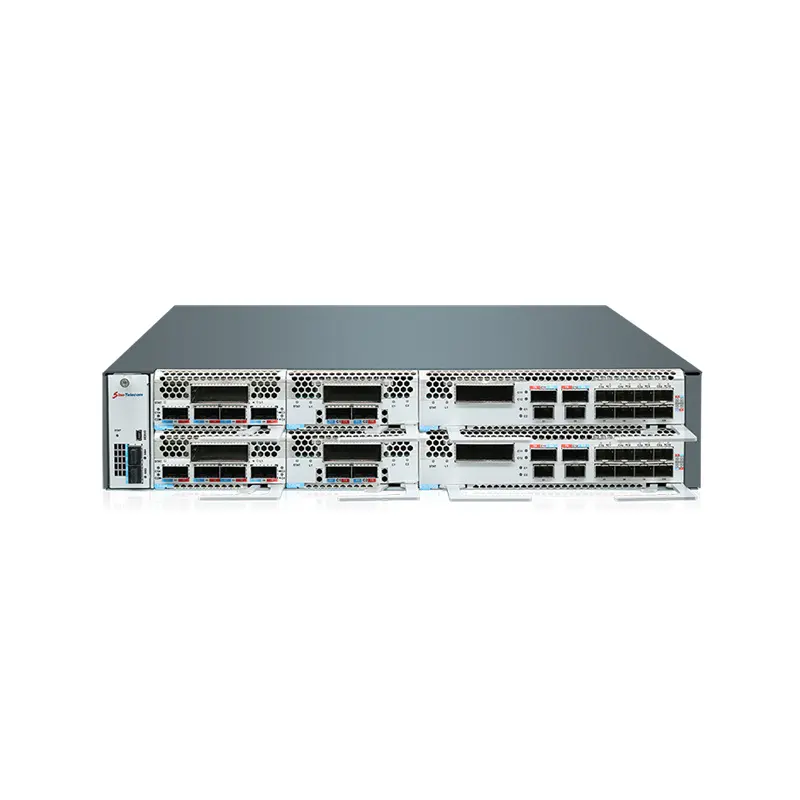
인공지능 워크로드가 데이터 센터 트래픽 패턴을 어떻게 변화시키는가
인공지능 인프라는 단일 건물 내에서 ‘확장’하는 방식에서, 종종 수 마일 떨어진 여러 시설로 구성된 클러스터 전체에 걸쳐 ‘확장’하는 방식으로 진화하고 있다. 전력, 공간, 냉각 능력의 고갈은 한 시설 내에서 인공지능 워크로드를 ‘확장’하는 것을 더 이상 실현 가능하지 않게 만든다. 따라서 IT 운영은 워크로드를 여러 데이터 센터에 분산시켜 ‘확장’해야 한다. ‘확장’에서 ‘확장’으로의 전환은 데이터 센터 내 트래픽 패턴을 재정의한다. 인공지능 워크로드는 클러스터 노드 간에 엄청난 양의 데이터를 긴밀하게 동기화된 방식으로 이동시켜야 한다. 이로 인해 발생하는 대규모 동서 방향 데이터 흐름은 기존 데이터 센터 상호 연결 트래픽 패턴을 완전히 압도한다. 예측 불가능한 초고속·초대용량의 광역 및 캠퍼스 규모 데이터 트래픽이 등장할 것이며, 기존 데이터 센터 네트워크는 이를 더 이상 효율적으로 처리할 수 없게 될 것이다.
왜 800G가 되다 AI 데이터 센터 간 연결에 필수적인가?
AI 학습 클러스터는 분산 병렬 처리 방식으로 작동하며, 이는 여러 데이터 센터 간 GPU 노드를 연결하기 위해 막대한 대역폭을 필요로 한다. 대규모 학습에서 생성되는 엄청난 양의 데이터를 처리하려면, 현재 데이터 센터 규모에서는 400G가 부족하다. 반면 800G는 DCI 파장당 용량을 두 배로 늘려 단일 파장 링크만으로도 AI 클러스터를 연결할 수 있게 해주며, 병렬 링크 여러 개를 사용할 필요가 없다. 이로 인해 장비 설치 공간과 운영 비용이 크게 줄어든다. 캠퍼스 또는 메트로 유형 네트워크에서 운영하는 경우, 학습 작업을 분산시키기 위해 800G DCI가 제공하는 높은 용량 밀도가 필요하며, 이는 광섬유 자원을 효율적으로 활용하는 데 기여한다.
광학 포로프터 기술 800G DCI의 핵심 기술: 코히런트, DCO, 그리고 광섬유 요구 사항
800G DCI 뒤에 있는 기술은 코히어런트 광학 기술인데, 이는 전송 목적을 위해 빛의 진폭과 이중 편광을 활용할 수 있게 해준다. 코히어런트 전송은 기존의 직접 검출 광학 방식보다 단일 파장에서 더 많은 정보를 밀집시켜 전송할 수 있게 한다. 코히어런트 기술을 기반으로 싱노텔레콤은 최대 800G까지 지원하는 DCI 보드를 제공한다. – 각 보드는 보드 상의 광 모듈 인터페이스를 통해 광 모듈 인터페이스를 지원한다. 이러한 지원은 유연한 배포 능력을 실현한다.
DCI 보드 설계 역시 모듈식이어야 하며, 필요 시 보드를 ‘핫 스왑’하여 용량을 언제든지 업그레이드할 수 있어야 한다. 보드가 여러 종류의 광 모듈과 다양한 전송 거리에 대한 인터페이스를 지원함으로써 배포 옵션이 최적화되고, 400G에서 800G로의 용량 확장을 포크리프트 업그레이드 없이 매끄럽게 수행할 수 있다.
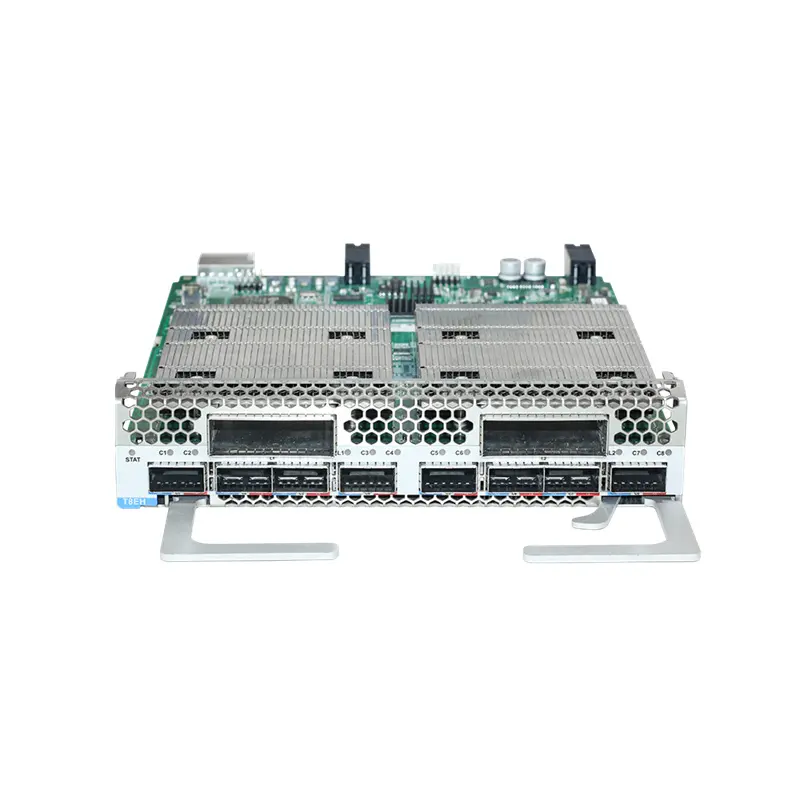
지연 시간 문제 in AI 클러스터 상호 연결
AI 훈련 워크로드는 지연 시간에 매우 민감합니다. 분산 훈련 중 서로 다른 GPU가 그래디언트를 집계할 때, 마이크로초 단위의 차이조차도 매우 큰 비용을 초래할 수 있습니다. 따라서 당사의 800G 코히어런트 솔루션은 매우 낮은 지연 시간에서 높은 용량을 제공합니다.
800LR 구현 방식은 앰프 없이 약 10km까지 전송할 수 있도록 설계되었으며, 종단 간 지연 시간을 250나노초 이하로 제공합니다. 반면 800ZR 프레이밍 방식은 종단 간 지연 시간이 1마이크로초를 넘습니다. 2 이러한 전광학 솔루션은 캠퍼스 규모의 AI 클러스터를 인근 위치에 배치할 경우 더 짧은 지연 시간을 실현할 수 있습니다. 그러나 거리가 더 길어질 경우, 현재는 전광학 메시 네트워크와 같은 고성능 아키텍처가 도입되고 있으며, 여기서는 엣지에서 코어까지의 지연 시간이 1밀리초 수준입니다. 전반적으로, 거리 조건이 적절하다면 800G 코히어런트 광학 기술의 지연 시간은 대부분의 AI 훈련 시나리오에서 여전히 허용 가능합니다.
현실 세계 800g 설치 고려 사항
AI 인프라에 800G DCI를 도입하려면 전력 및 열 관리 등 여러 영역을 종합적으로 계획해야 한다. 800G ZR 모듈은 24–25W 범위에서 작동하므로 전력 소비가 주요 고려 사항이 된다. 플랫폼이 이 수준의 전력 소비를 충분히 냉각할 수 있는지, 특히 포트 밀도 측면에서 적절한 냉각 능력을 갖추고 있는지 반드시 확인해야 한다. 스위치/라우터가 800G 포트로 완전히 장착되었을 때 열적 한계를 고려해 지원 여부를 점검하라.
거리 요소도 반드시 고려해야 한다. 800ZR은 증폭기(amp)를 사용할 경우 최대 120km까지 전송 가능하며, 메트로 단위 DCI 용도에 적합하다. 또한 메트로 캠퍼스 네트워크용 저전력 800LR 솔루션을 통해 지연 시간을 낮출 수 있다. 메트로 에지 전광 스위치는 메시 토폴로지 기반으로 결정론적 지연 시간 구간(1ms, 5ms, 10ms)을 제공하며, 분산 AI 클러스터 전체의 트래픽을 통합 처리할 수 있다.
준비 용 다음 단계: 1.6T DCI 진화
그리고 1.6T로 가는 길이 점차 뚜렷해지고 있다. 이에 따라 OIF는 1600ZR 및 1600ZR+의 구현 협약을 추진 중이다. 차세대 코히어런트 솔루션에서는 고급 DSP와 더 높은 보드레이트를 적용함으로써 전송 거리를 희생하지 않고 용량을 두 배로 늘릴 수 있을 것이다.
이 변화는 싼오텔레콤 같은 기업들에 의해 주도되고 있다. 당사는 모듈식이며 미래에 대비한 플랫폼을 기반으로 DCI 포트폴리오를 개발하여 현재의 800G 요구사항을 충족시키고, 1.6T로의 간편한 업그레이드를 보장한다. 당사의 광학 플랫폼은 241개의 특허를 바탕으로 하며, 최첨단 R&D 센터를 활용해 800ZR을 넘어서 1.6T에 이르기까지 다양한 최신 코히어런트 광학 기술을 구현한다.
결론
AI 워크로드가 단일 시스템 확장(scale up)에서 분산 캠퍼스 및 메트로 클러스터로의 확장(scale out)으로 이동함에 따라, 800G DCI는 핵심 구성 요소가 되고 있다. 이 기술은 파장당 용량을 두 배로 늘리고, 비트당 전력 소비를 낮추며, 동기식 GPU 훈련에 필수적인 250나노초 미만의 지연 시간을 제공한다. 또한 명시적인 1.6T 로드맵을 통해 고객의 투자를 오래도록 유효하게 유지한다. 모듈식 싱오 텔레콤 STN6800 D16 OTN 플랫폼과 업계 최다 규모의 800ZR/800LR 코히어런트 플러그어블 제품군, SNMP/NETCONF 인터페이스를 지원하는 개방형 NMS, 그리고 간단한 1.6T 업그레이드가 가능한 미래 대비 모듈식 섀시를 갖춘 싱오 텔레콤의 광학 계층은 속도, 전달 거리, 전력 효율, 비용 사이에서 균형 잡힌 조합을 제시하며, 오늘날과 내일의 AI 네트워킹 요구 사항을 최적화하여 지원한다. 세계 최정상급 DCI 공급업체로서, 전 세계에 10만 대 이상이 설치된 실적을 바탕으로, 싱오 텔레콤은 10년간 축적된 전문성, 검증된 탄탄한 공급망, 30개국 이상을 아우르는 글로벌 네트워크를 활용해 모든 단계에서 성공을 보장한다—광섬유에서 가장 먼 노드까지, 문제 없고 미래에 대비된 AI 데이터 인프라 전환을 최적화한다. 지금 바로 싱오 텔레콤 영업팀에 문의하여 솔루션부터 실행까지 완전한 제안을 받아보시기 바란다. 이는 데이터센터 상호연결 분야에서 10년간의 리더십을 기반으로 한다.