
 EN
Rollen til optiske nettverk er avgjerande for å realisere storskalige AI-nettverk. Etter som AI-arbeidslastar strekkjer seg utanfor grensene til eit data-senter, har 400G Ethernet-optiske løysingar for DCI utvikla seg til ein uunnværlig kjerne-teknologi for moderne AI-data-senter-nettverk. I dagens komplekse AI-data-senter-arkitektur er AI-arbeidslastar ikkje berre avgrensa til eitt data-senter, og for å møte utfordringane med AI i stor skala, er høgfrekvente tilkoplingar som 800G nødvendige DCI blir en viktig måte å bygge ut AI-infrastruktur for neste generasjon på.
Hvordan AI-arbeidsbelastninger endrer trafikkmønstre i data sentre
AI-infrastruktur utvikler seg fra «skalering oppover» innenfor ett enkelt bygg til «skalering utover» over en gruppe anlegg, ofte flere kilometer fra hverandre. Å gå tom for strøm, plass og evne til å kjøle et anlegg gjør det enkelt umulig å «skalere opp» AI-arbeidsbelastningen på ett enkelt anlegg. Det betyr at IT-drift må «skalere utover» ved å spre arbeidsbelastningen over flere data sentre. Skiftet fra skalering oppover til skalering utover definerer trafikkmønstrene i data sentre på nytt. AI-arbeidsbelastninger krever bevegelse av enorme mengder data på en nøyaktig synkronisert måte mellom klusternoder. De resulterende store øst-vest-datastrømmene overgår fullstendig tradisjonelle trafikkmønstre for interkobling av data sentre. Det ligger en fremtid med uforutsigbar, høyhastighets-, høykapasitets-, metropolitansk og campusomfattende datatrafikk foran oss – en trafikk som data senter-nettverk ikke lenger kan håndtere effektivt.
Hvorfor 800G har Blir Kritisk betydning for AI-datacenterinterkobling
AI-treningskluster fungerer ved hjelp av distribuert parallell behandling, noe som krever enorme mengder båndbredde på tvers av mange datacentre for å koble sammen GPU-noder. 400G er ikke tilstrekkelig for den mengden data som store skala-treningsprosesser genererer, på denne skalaen, i datacentrene. Med 800G DCI har du doblet kapasiteten per bølgelengde og lar operatører koble sammen AI-kluster ved hjelp av én enkelt bølgelengdelinje i stedet for flere parallelle linjer. Plassbehovet og driftskostnadene er betydelig lavere. For operatører i campus- eller metronettverk må de, for å tillate distribuert trening, ha den høye kapasitetstettheten som 800G DCI gir dem – og dette sikrer effektiv bruk av fiber.
Den optiske Teknologi Bak 800G DCI: koherent teknologi, DCO og fiberkrav
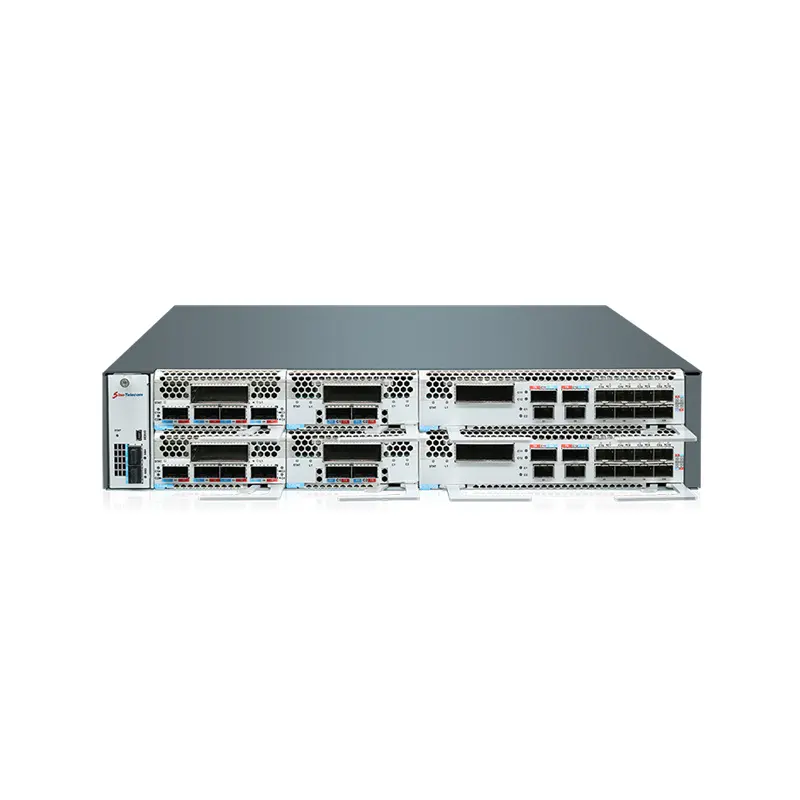
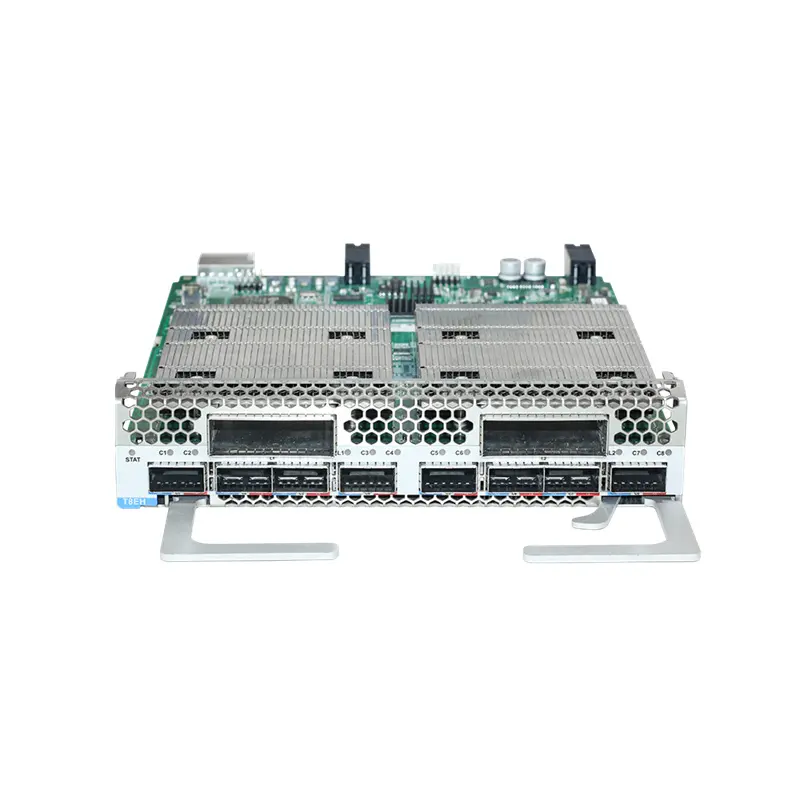
Teknologien bak 800G DCI er koherent optikk, fordi den tillater bruk av lysamplitude og dobbel polarisering til overføringsformål. Koherent overføring tillater en mer informasjonsrik overføring over én enkelt bølgelengde enn den tradisjonelle direkte-deteksjons-optikktilnærmingen. Basert på grunnlaget av koherent teknologi tilbyr Sino-Telecom DCI-kort som støtter opptil 800G per kort – og hvert kort støtter grensesnittene for optiske moduler via det optiske modulgrensesnittet på kortet. Denne støtten gir fleksible implementeringsmuligheter.
DCI-kortets design bør også være modulært, slik at kapasiteten kan oppgraderes når som helst ved «hot swapping» av kortet. Å ha grensesnittstøtte for flere typer optiske moduler og ulike overføringsavstander på kortet optimaliserer implementeringsalternativene og gir oss mulighet til å skalerte kapasiteten (fra 400G til 800G) sømløst uten behov for en fullstendig utskiftning av utstyret.
Latensutfordringer i AI-klysterinterkobling
AI-treningsarbeidsmengder er svært følsomme for forsinkelse. Hver mikrosekund-forskjell når ulike GPU-er i distribuert trening må samle sine gradienter, kan bli svært kostbar. Derfor vil våre 800G-koherente løsninger gi høy kapasitet med svært lav forsinkelse.
800LR-utgaven, som er beregnet på ikke-forsterkede avstander på opptil ca. 10 km, gir end-to-end-forsinkelse under 250 nanosekunder. Sammenlign dette med 800ZR-rammeverk, der end-to-end-forsinkelsen overstiger 2 mikrosekund. Dette bør tillate kortere forsinkelse med disse helt-optiske løsningene for AI-klyster i campus-størrelse ved nærliggende lokasjoner. Ved større avstander settes imidlertid høyarkitekturløsninger, som f.eks. helt-optiske mesh-nettverk med 1 ms kant-til-kjerne-forsinkelse, for tiden i drift for AI-trening over større områder. Generelt vil forsinkelsen for 800G-koherente optikk fortsatt være akseptabel i de fleste tilfellene for AI-trening, så lenge avstanden er passende.
Fra virkeligheten 800g Overveielser ved installasjon
Å implementere 800G DCI i AI-infrastruktur innebär å planlegge flere områder, blant anna strøm- og termiske forhold. 800G ZR-modulene bruker 24–25 W, så strømforbruket må tas hensyn til. Sørg for å vite om plattformene dine har riktig kjøling for dette – spesielt når det gjelder hvor mange porter de kan romme. Sjekk hva slags termisk støtte switche/routere dine har når de er utstyrt med 800G-porter.
Avstanden må også tas med i betraktning. 800ZR har en rekkevidde på opptil 120 km med forsterker og passer godt til metro-DCI-brukstilfeller. Vi har lavstrømversjoner av 800LR for brukstilfeller som reduserer latenstiden i metro-campusnettverk. Metrokantens all-optiske switche kan gi deterministiske latenstider (1 ms, 5 ms og 10 ms) ved hjelp av mesh-topologi og håndtere all AI-trafikk for en distribuert kluster.
Forbereder for neste steg: 1,6T DCI-utvikling
Og veien mot 1,6 T ser ut til å være synlig. I svar på dette arbeider OIF med implementeringsavtaler for 1600ZR og 1600ZR+. Avansert DSP og høyere baudrate i fremtidige generasjoner av koherente løsninger vil doble kapasiteten uten å ofre rekkevidde.
Denne endringen drives av selskaper som Sino-Telecom. Vi utvikler vårt DCI-portefølje basert på modulære, fremtidssikrede plattformer som støtter dagens 800G-krav og sikrer enkel oppgradering til 1,6T. Våre optiske plattformer omfatter 241 patenter og bygger på et moderne FoU-senter for å implementere ulike nyeste koherente optiske teknologier, inkludert den nyeste generasjonen – fra 800ZR og videre til 1,6T.
Konklusjon
Ettersom AI- arbeidsbelastninger flyttes fra skaleringsoppover til skaleringsutover over distribuerte campus- og byområdesystemer, blir 800G DCI den avgjørende byggestenen – med dobbelt kapasitet per bølgelengde, lav effektforbruk per bit og forsinkelse under 250 ns, som kreves for synkron GPU-trening. En tydelig 1,6T-vei framover sikrer at investeringene dine forblir aktuelle. Med det modulære Sino Telecom STN6800 D16 OTN-plattformen og bransjens mest omfattende utvalg av 800ZR/800LR-koherente pluggbare enheter, et åpent NMS med SNMP/NETCONF-tilgang og en fremtidssikret modulær chassis som er klar for enkel oppgradering til 1,6T, tilbyr Sino Telecoms optiske lag en balansert kombinasjon av hastighet, rekkevidde, effektforbruk og kostnad – designet for å optimalt støtte dagens og morgendagens AI-nettverkskrav. Som verdens ledende DCI-leverandør – med over 100 000 enheter satt i drift verden over – utnytter vi ti år med ekspertise, en bevist og robust leveranskjede samt en global tilstedeværelse i mer enn 30 land for å sikre suksess ved hver enkelt fase – fra fiberen til den ytterste noden, for en problemfri og fremtidssikret overgang til AI-datainfrastruktur. Ta kontakt med Sino Telecoms salgsteam i dag for et tilbud – et komplett tilbud fra løsningsutforming til gjennomføring, drevet av ti år med lederskap innen datacenterinterkobling.
Innholdsfortegnelse
- Hvordan AI-arbeidsbelastninger endrer trafikkmønstre i data sentre
- Hvorfor 800G har Blir Kritisk betydning for AI-datacenterinterkobling
- Den optiske Teknologi Bak 800G DCI: koherent teknologi, DCO og fiberkrav
- Latensutfordringer i AI-klysterinterkobling
- Fra virkeligheten 800g Overveielser ved installasjon
- Forbereder for neste steg: 1,6T DCI-utvikling
- Konklusjon