
 EN
Die Rolle des optischen Netzwerks ist entscheidend für die Realisierung des großskaligen KI-Netzwerks. Da KI-Arbeitslasten über die Grenzen eines Rechenzentrums hinausreichen, haben sich 400G-Ethernet-Optiklösungen für DCI zu einer unverzichtbaren Kerntechnologie für moderne KI-Rechenzentrumsnetzwerke entwickelt. In der heutigen komplexen Architektur von KI-Rechenzentren beschränken sich KI-Arbeitslasten nicht mehr nur auf ein einzelnes Rechenzentrum; um den Herausforderungen der skalierbaren KI zu begegnen, sind Hochgeschwindigkeitsverbindungen wie 800G erforderlich. DCI werden zu einer wichtigen Methode, die KI-Infrastruktur der nächsten Generation aufzubauen.
Wie sich durch KI-Arbeitslasten die Datenverkehrsmuster in Rechenzentren verändern
Die KI-Infrastruktur entwickelt sich vom „Skalieren nach oben“ innerhalb eines einzelnen Gebäudes hin zum „Skalieren nach außen“ über einen Verbund von Standorten, die oft mehrere Kilometer voneinander entfernt liegen. Ein Mangel an Strom, Platz und Kühlkapazität macht es einfach unmöglich, die KI-Arbeitslast an einem einzigen Standort weiter „nach oben“ zu skalieren. Daher müssen IT-Betriebsabläufe „nach außen“ skalieren, indem sie die Arbeitslast auf mehrere Rechenzentren verteilen. Der Übergang vom Skalieren nach oben zum Skalieren nach außen definiert die Datenverkehrsmuster in Rechenzentren neu. KI-Arbeitslasten erfordern den synchronisierten Transfer enormer Datenmengen zwischen Cluster-Knoten. Die daraus resultierenden großen Ost-West-Datenströme übertreffen herkömmliche Rechenzentrum-Interconnect-Verkehrsmuster bei weitem. Es zeichnet sich eine Zukunft ab, in der hochgeschwindigkeitsfähiger, hochkapazitiver Datenverkehr über Metropolregionen und Campus hinweg zunehmend unvorhersehbar wird – ein Verkehr, den Rechenzentrumsnetzwerke nicht mehr effizient bewältigen können.
Warum 800G Werden Kritisch für die Verbindung von KI-Rechenzentren ist
KI-Trainingscluster arbeiten mit verteilter paralleler Verarbeitung, wofür enorme Bandbreitenmengen zwischen vielen Rechenzentren erforderlich sind, um GPU-Knoten zu verbinden. 400G reicht für diese Datenmenge, die bei großskaligem Training in Rechenzentren entsteht, nicht aus. Mit 800G DCI verdoppeln Sie die Kapazität pro Wellenlänge und ermöglichen es Betreibern, KI-Cluster über eine einzige Wellenlängenverbindung statt über mehrere parallele Verbindungen zu koppeln. Die physische Größe und die Betriebskosten sind deutlich geringer. Für Betreiber in Campus- oder Metropolitan-Netzwerken ist zur Verteilung des Trainings die hohe Kapazitätsdichte erforderlich, die 800G DCI bietet – dies gewährleistet eine effiziente Nutzung der Faser.
Das Optische Technologie Hinter 800G DCI: Kohärente Technologie, DCO und Anforderungen an die Faser
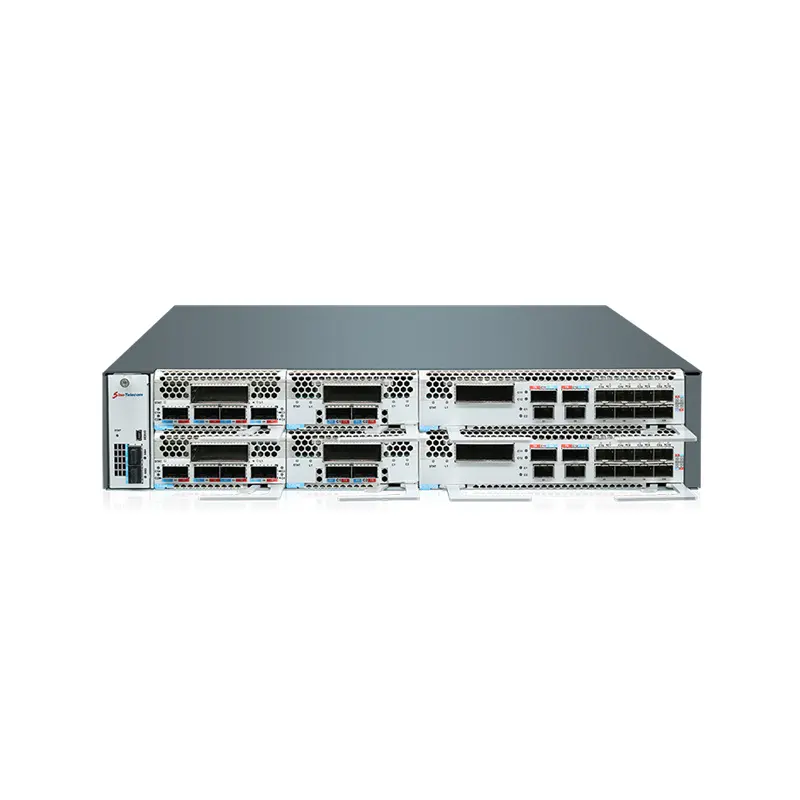
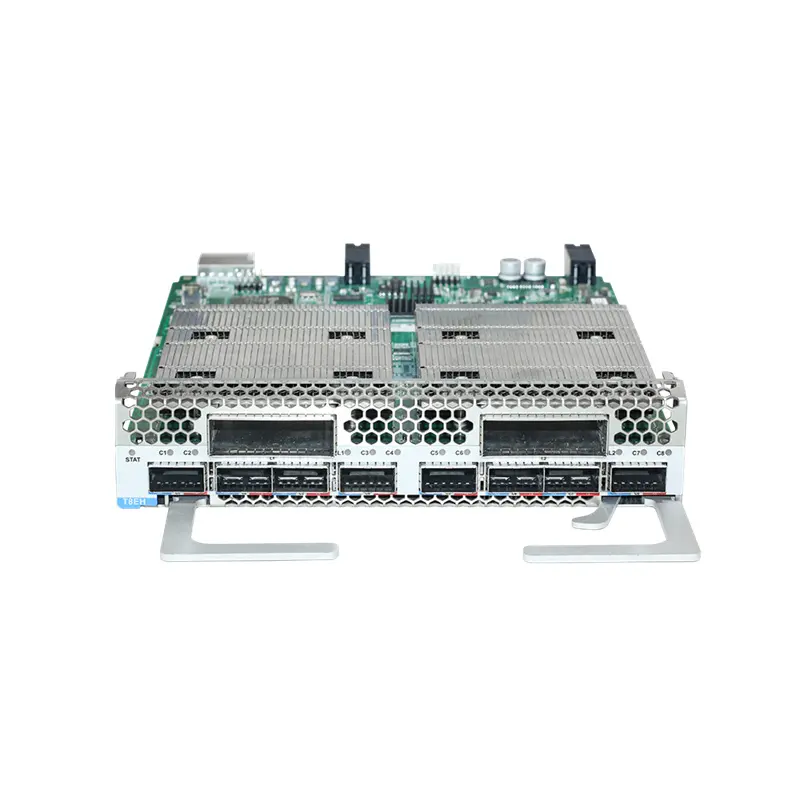
Die Technologie hinter 800G-DCI ist die kohärente Optik, da sie die Nutzung der Lichtamplitude und der dualen Polarisation für Übertragungszwecke ermöglicht. Die kohärente Übertragung erlaubt eine informationsdichtere Übertragung über eine einzelne Wellenlänge als der traditionelle Direct-Detection-Optik-Ansatz. Auf der Grundlage der kohärenten Technologie bietet Sino-Telecom DCI-Boards mit Unterstützung von bis zu 800G pro Board an. – jedes Board unterstützt die optischen Modulschnittstellen über die optische Modulschnittstelle auf dem Board. Diese Unterstützung bietet flexible Einsatzmöglichkeiten.
Das Design des DCI-Boards sollte ebenfalls modular sein, sodass seine Kapazität bei Bedarf durch ein „Hot-Swapping“ des Boards problemlos erweitert werden kann. Die Unterstützung verschiedener optischer Module und Übertragungsdistanzen auf dem Board optimiert die Einsatzoptionen und ermöglicht eine nahtlose Skalierung der Kapazität (von 400G auf 800G), ohne dass ein kompletter Austausch („forklift upgrade“) erforderlich ist.
Latenz-Herausforderungen in KI-Cluster-Vernetzung
KI-Trainingsworkloads sind äußerst latenzempfindlich. Jeder Mikrosekunden-Unterschied, wenn verschiedene GPUs beim verteilten Training ihre Gradienten aggregieren müssen, kann sehr kostspielig sein. Daher bieten unsere 800-G-Coherent-Lösungen hohe Kapazität bei sehr geringer Latenz.
Die 800LR-Implementierung, die für unverstärkte Distanzen von bis zu etwa 10 km vorgesehen ist, liefert eine End-to-End-Latenz unter 250 Nanosekunden. Vergleichen Sie dies mit der 800ZR-Framing-Technik, bei der die End-to-End-Latenz mehr als 2 mikrosekunde beträgt. Dadurch sollten diese voll-optischen Lösungen für KI-Cluster in Campusgröße an nahegelegenen Standorten kürzere Latenzen ermöglichen. Bei größeren Entfernungen werden derzeit jedoch hochgradige Architekturen wie voll-optische Mesh-Netzwerke mit einer Edge-zu-Core-Latenz von 1 ms für KI-Training über größere Gebiete implementiert. Insgesamt bleibt die Latenz bei 800-G-Coherent-Optik in den meisten Fällen für KI-Training akzeptabel, sofern die Distanz geeignet ist.
Real-world 800G Einsatzüberlegungen
Die Implementierung von 800G-DCI in AI-Infrastrukturen erfordert die Planung mehrerer Aspekte – insbesondere Stromversorgung und Thermik. 800G-ZR-Module arbeiten im Leistungsbereich von 24–25 W; daher ist die Stromversorgung ein zentrales Thema. Stellen Sie sicher, dass Ihre Plattformen über die erforderliche Kühlleistung verfügen, um die gewünschte Anzahl an Ports zu unterstützen. Prüfen Sie, welche thermischen Belastungen Ihre Switches/Routers bei voller Bestückung mit 800G-Ports verkraften.
Auch die Übertragungsdistanz muss berücksichtigt werden. Der 800ZR bietet eine Reichweite von bis zu 120 km mit Verstärker und eignet sich somit für Metro-DCI-Anwendungsfälle. Für Metro-Campus-Netzwerke stehen energieeffiziente 800LR-Anwendungsfälle zur Verfügung, die die Latenz senken. Optische Metro-Edge-Switches ermöglichen deterministische Latenzzyklen (1 ms, 5 ms und 10 ms) in Mesh-Topologien und bündeln den gesamten AI-Datenverkehr eines verteilten Clusters.
Vorbereiten für der nächste Schritt: 1,6T-DCI-Evolution
Und der Weg zu 1,6 T scheint erkennbar zu sein. Darauf reagiert die OIF mit der Ausarbeitung von Implementierungsvereinbarungen für 1600ZR und 1600ZR+. Fortgeschrittene DSP-Technologie und höhere Baudraten in zukünftigen Generationen kohärenter Lösungen werden die Kapazität verdoppeln, ohne die Reichweite einzubüßen.
Diese Entwicklung wird von Unternehmen wie Sino-Telecom vorangetrieben. Unser DCI-Portfolio entwickeln wir auf modularen, zukunftssicheren Plattformen, die sowohl die aktuellen 800G-Anforderungen erfüllen als auch ein einfaches Upgrade auf 1,6 T garantieren. Unsere optischen Plattformen basieren auf 241 Patenten und nutzen das hochmoderne F&E-Zentrum, um eine breite Palette neuester kohärenter Optiktechnologien umzusetzen – darunter die jüngste Generation, die über 800ZR hinaus bis zu 1,6 T reicht.
Fazit
Während KI-Arbeitslasten von der Skalierung nach oben hin zu einer verteilten Skalierung über Campus- und Metropolregion-Cluster migrieren, wird 800G DCI zum entscheidenden Baustein: Es bietet die doppelte Kapazität pro Wellenlänge, geringe Energie pro Bit sowie eine Latenz unter 250 ns – Voraussetzungen für synchrones GPU-Training. Ein klar definierter 1,6-Terabit-Roadmap hält Ihre Investitionen auf dem neuesten Stand. Mit der modularen Sino Telecom STN6800 D16 OTN-Plattform sowie dem umfassendsten Branchenangebot an 800ZR-/800LR-kohärenten Steckmodulen, einem offenen NMS mit SNMP-/NETCONF-Zugriff und einem zukunftssicheren, modularen Chassis, das einfache Upgrades auf 1,6 Tbit/s ermöglicht, bietet Sino Telecom eine ausgewogene Mischung aus Geschwindigkeit, Reichweite, Energieeffizienz und Kosten – speziell entwickelt, um die Netzwerkanforderungen für KI sowohl heute als auch morgen optimal zu unterstützen. Als weltweit führender DCI-Anbieter – mit über 100.000 Einheiten weltweit im Einsatz – nutzen wir zehn Jahre Erfahrung, eine bewährte und robuste Lieferkette sowie eine globale Präsenz in mehr als 30 Ländern, um Ihren Erfolg bei jedem Schritt sicherzustellen: von der Glasfaser bis zum entferntesten Knoten optimieren wir alles für einen störungsfreien und zukunftsfähigen Übergang zur KI-Dateninfrastruktur. Kontaktieren Sie noch heute das Vertriebsteam von Sino Telecom für ein Angebot – ein komplettes Angebot von der Lösung bis zur Umsetzung, getragen von zehn Jahren Führungserfahrung im Bereich Data-Center-Interconnectivity.
Inhaltsverzeichnis
- Wie sich durch KI-Arbeitslasten die Datenverkehrsmuster in Rechenzentren verändern
- Warum 800G Werden Kritisch für die Verbindung von KI-Rechenzentren ist
- Das Optische Technologie Hinter 800G DCI: Kohärente Technologie, DCO und Anforderungen an die Faser
- Latenz-Herausforderungen in KI-Cluster-Vernetzung
- Real-world 800G Einsatzüberlegungen
- Vorbereiten für der nächste Schritt: 1,6T-DCI-Evolution
- Fazit